Chatbot arena : comment les modèles de langage sont-ils classés ?
Julie Ferrand
septembre 1, 2026 · 23 min
Comparer des modèles de langage n’a rien d’anecdotique quand on doit choisir une base fiable pour un chatbot, un assistant commercial ou un agent de support. Derrière les annonces marketing, une question reste centrale : qui décide réellement qu’une IA est meilleure qu’une autre ? Chatbot Arena, aussi appelée LMArena dans de nombreuses analyses, s’est imposée comme un repère parce qu’elle confronte les systèmes en duel, sur des usages réels, avec un classement mis à jour à partir de préférences humaines. Le principe paraît simple. En pratique, il faut savoir lire les scores, comprendre la logique Elo, repérer les biais et relier ces résultats à vos objectifs business.
Pour un dirigeant de PME, le vrai sujet n’est pas de savoir quel laboratoire publie le modèle le plus impressionnant. Le vrai sujet est de savoir quelle solution répond le mieux à vos clients, dans votre contexte, avec un coût acceptable et une qualité stable. C’est là que l’évaluation devient utile. Encore faut-il distinguer la démonstration publique de la performance opérationnelle. Cet article décrypte le fonctionnement de l’arena, les raisons de la domination de certains acteurs comme ChatGPT-4o, la place de concurrents comme Gemini 1.5, et surtout ce que ce classement dit vraiment pour un projet d’intelligence artificielle conversationnelle en entreprise.
En bref
- Chatbot Arena compare des modèles par affrontement direct, sur la base de votes humains.
- Le classement repose sur un système de type Elo, connu dans les échecs et les compétitions.
- ChatGPT-4o-latest a longtemps dominé les catégories majeures : instruction, code, mathématiques et prompts complexes.
- Gemini 1.5 s’est imposé comme un rival sérieux, surtout sur certains raisonnements et tâches difficiles.
- Une bonne place dans l’arena ne garantit pas à elle seule le meilleur choix pour une PME.
- L’évaluation utile doit relier qualité des réponses, coût, délais, sécurité et intégration métier.
Chatbot Arena : un classement de modèles de langage basé sur des duels réels
Chatbot Arena s’est fait une place parce qu’elle répond à une faiblesse récurrente du marché : les éditeurs comparent souvent leurs propres modèles avec leurs propres tests. Le problème est évident. Quand chacun définit son terrain, chacun peut paraître premier. L’arena prend une autre route. Elle met deux systèmes face à face, de manière souvent anonyme pour l’utilisateur, puis demande lequel répond le mieux à une requête donnée. Cette mécanique rend le jugement plus concret, car il porte sur un échange réel et non sur une promesse commerciale.
Pour comprendre l’intérêt de cette méthode, imaginez une PME française qui veut déployer un assistant sur son site pour filtrer les demandes avant transfert au support. Le dirigeant n’a pas besoin d’un discours abstrait sur le NLP ou le traitement du langage naturel. Il veut savoir quel moteur répond le plus clairement, évite les erreurs grossières, suit une consigne et gère plusieurs tours de dialogue. L’arena apporte justement une lecture orientée usage. Elle ne mesure pas seulement une capacité théorique. Elle observe une préférence humaine dans des situations variées.
- Duel anonyme entre deux modèles pour limiter l’influence de la marque
- Vote utilisateur fondé sur la qualité perçue des réponses
- Mise à jour continue du classement selon les nouveaux affrontements
Cette logique explique pourquoi la plateforme est devenue une référence citée dans de nombreux décryptages, comme ce guide sur Chatbot Arena ou encore cette analyse du système Elo appliqué aux LLM. Le succès de l’outil tient à un point simple : il rend visible l’écart entre des modèles qui semblent proches sur le papier, mais très différents dès qu’on les confronte à un cas réel.
> Un classement utile n’est pas celui qui flatte un laboratoire. C’est celui qui aide à choisir un modèle capable de tenir la route face à un utilisateur exigeant.
À retenir : Chatbot Arena mesure une préférence humaine dans des confrontations directes, ce qui la rend plus parlante qu’un benchmark purement théorique pour des décideurs non techniques.
Cette approche n’est pas parfaite, mais elle est redoutablement lisible. Quand un modèle gagne régulièrement face à des concurrents solides, cela indique une constance perçue. C’est précisément ce qui a maintenu ChatGPT-4o au sommet sur plusieurs tableaux de bord commentés à partir des données 2024, encore largement reprises dans les lectures comparatives du marché jusqu’en 2026. Pour aller plus loin sur les bases d’une IA conversationnelle exploitable en entreprise, vous pouvez aussi consulter ce guide PME sur l’IA conversationnelle.
| Critère | Chatbot Arena | Benchmark laboratoire | Test interne entreprise |
|---|---|---|---|
| Source des jugements | Utilisateurs humains | Équipe éditrice | Métier et service client |
| Lecture du résultat | Très visible | Parfois complexe | Très concrète |
| Utilité pour une PME | Bonne pour présélection | Moyenne | Excellente pour décision finale |
| Risque de biais | Modéré | Élevé | Variable |
Le point décisif, c’est donc moins l’existence d’un palmarès que sa méthode. L’arena ne remplace pas vos tests métier, mais elle évite de partir à l’aveugle. C’est ce pont entre visibilité publique et pré-sélection pragmatique qui mène naturellement à la vraie question : comment le score est-il calculé ?
Système Elo, votes humains, catégories : comment fonctionne réellement le classement
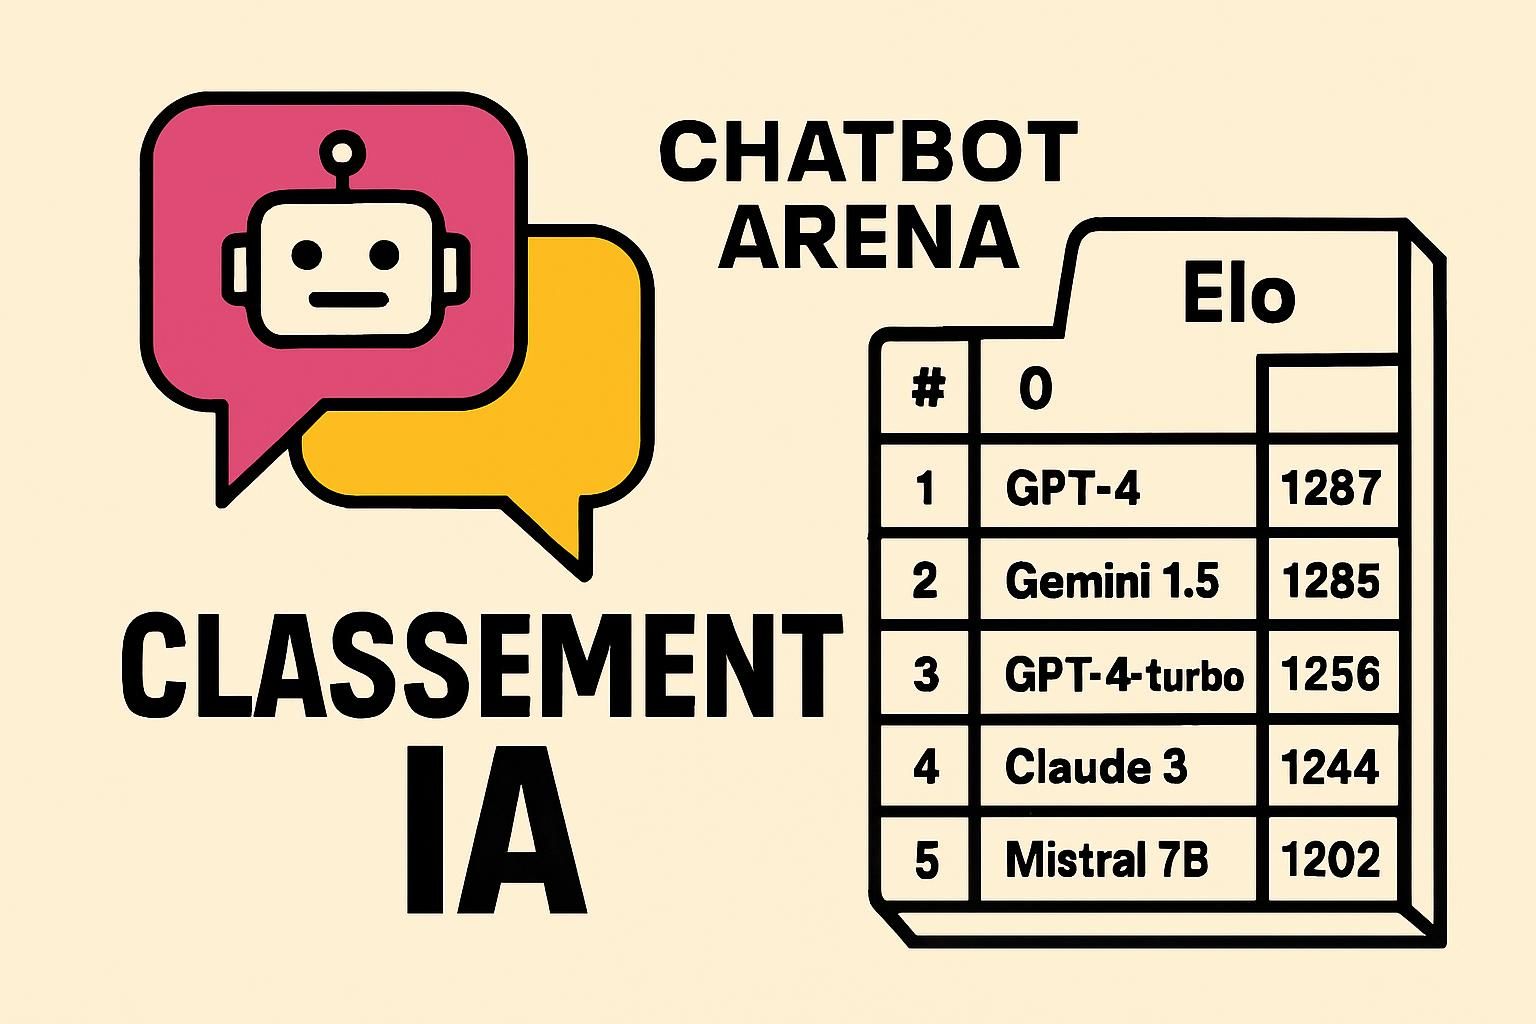
Le cœur du dispositif repose sur le système Elo, bien connu dans les échecs. L’idée est simple : un modèle gagne des points quand il bat un autre modèle, surtout si l’adversaire était mieux classé. À l’inverse, perdre face à un concurrent moins bien noté coûte davantage. Ce système a une vertu rare dans l’univers de l’intelligence artificielle : il reste compréhensible sans être simpliste. Chaque nouveau vote ajuste le classement, ce qui permet une photographie vivante du rapport de force.
Concrètement, un utilisateur pose une question. Il reçoit deux réponses sans toujours savoir quel système se cache derrière. Il choisit celle qui lui paraît meilleure, plus utile, plus juste ou plus claire. C’est cette décision qui alimente l’évaluation. Ce mécanisme est important, car il récompense la perception de qualité. Or, dans un projet de relation client, la perception vaut souvent autant que la justesse technique. Une réponse légèrement moins savante mais plus claire peut générer une meilleure satisfaction.
- L’utilisateur envoie un prompt ou une question.
- Deux modèles produisent une réponse en parallèle.
- L’utilisateur vote pour la meilleure sortie ou signale une égalité.
- Le score Elo de chaque modèle est recalculé.
- Le classement évolue au fil des milliers d’interactions.
Conseil : si vous utilisez l’arena pour présélectionner un moteur, observez les résultats globaux mais aussi les catégories où votre usage est le plus sensible : suivi d’instructions, dialogues multi-tours, calcul, extraction d’informations ou rédaction.
Les tableaux les plus commentés distinguent souvent plusieurs dimensions : codage, mathématiques, instruction following, prompts difficiles, ou échanges sur plusieurs tours. Cette granularité est utile. Un modèle peut sembler brillant en raisonnement pur, mais moins discipliné lorsqu’il doit respecter un ton, une structure de réponse ou une contrainte métier. C’est là qu’un dirigeant évite une erreur fréquente : croire qu’un numéro un global sera forcément le meilleur dans son cas particulier.
Si vous cherchez une vue plus large de la logique du leaderboard, ce classement de modèles IA permet de croiser différentes lectures. En parallèle, notre décryptage des modèles de langage pour chatbot aide à relier ces scores à des besoins concrets d’entreprise. Les deux approches sont complémentaires : la première aide à voir qui domine, la seconde aide à comprendre pourquoi cela compte, ou non, pour votre activité.
> Un bon score Elo indique une forte préférence comparative. Il ne dit pas encore si le modèle respecte vos contraintes de prix, de sécurité ou de données.
Attention : un classement participatif peut favoriser certains types de prompts plus populaires que d’autres. Un modèle excellent sur des cas très médiatisés peut paraître surévalué pour un usage B2B étroit et répétitif.
Il faut aussi parler du facteur volume. Plus un modèle a participé à des confrontations variées, plus son score devient significatif. Un nouvel entrant peut grimper vite s’il impressionne dans ses premiers matchs, puis se tasser quand le nombre de tests augmente. C’est exactement pour cela qu’il faut éviter les lectures instantanées. Une progression rapide attire l’œil. Une stabilité sur la durée rassure davantage un décideur qui cherche une base fiable pour six ou douze mois.
| Élément | Ce qu’il mesure | Ce que cela ne mesure pas |
|---|---|---|
| Score Elo | Capacité à gagner des duels | Coût total de déploiement |
| Vote humain | Préférence perçue | Conformité réglementaire |
| Catégorie math/code | Compétence ciblée | Qualité du service client final |
| Multi-turn | Tenue du dialogue | Intégration CRM ou téléphonie |
En résumé opérationnel, l’arena est un excellent baromètre de qualité comparative. Mais un baromètre ne remplace pas une décision d’achat. C’est ce décalage qui explique pourquoi la domination d’un modèle comme ChatGPT-4o-latest doit être interprétée avec méthode plutôt qu’avec enthousiasme automatique.
Testez AirAgent gratuitement →
Si votre objectif n’est pas de commenter le classement mais d’automatiser des échanges utiles, cette étape de lecture du score doit déboucher sur une autre analyse : quels modèles tiennent vraiment la tête, et sur quels critères précis ?
ChatGPT-4o, Gemini 1.5, Grok et Claude : ce que le top du classement révèle vraiment
Les enseignements tirés des données largement commentées à partir du 4 septembre 2024 ont marqué durablement le marché. Le constat principal était net : ChatGPT-4o-latest occupait la première place dans l’ensemble des catégories majeures. Cela incluait le codage, le suivi d’instructions, les tâches mathématiques et les prompts complexes. Cette domination n’était pas un simple effet d’image. Elle traduisait une vraie régularité. Pour une entreprise, cette régularité vaut de l’or, car elle réduit la variabilité d’expérience entre deux demandes proches.
Derrière lui, Gemini 1.5 s’est affirmé comme le concurrent le plus crédible, avec plusieurs versions capables d’atteindre la deuxième ou la troisième place selon les catégories. Son positionnement était particulièrement solide sur les tâches analytiques, notamment les mathématiques et certains prompts exigeants. En revanche, les lectures du marché montraient souvent une réserve sur le code ou sur certaines interactions plus fines. C’est un point majeur : un outsider très fort sur une spécialité peut séduire, sans forcément devenir le meilleur moteur généraliste pour un agent conversationnel d’entreprise.
- ChatGPT-4o : très bon niveau global, forte polyvalence, grande constance
- Gemini 1.5 : excellent sur plusieurs raisonnements complexes, concurrence directe crédible
- Grok-2 : bon niveau général, mais moins homogène selon les cas
- GPT-4.0-2024-05-13 : solide mais dépassé par les versions plus récentes
- Claude 3.5 Sonnet : performant sur certains exercices précis, avec une perception qualitative élevée
Bon à savoir : un modèle qui brille sur les mathématiques n’est pas forcément celui qui produira les meilleures réponses pour un support client, une qualification de leads ou une assistance RH.
Le cas de Claude-3.5-Sonnet illustre bien cette nuance. Il a souvent été remarqué pour ses résultats sur certaines tâches de raisonnement ou de mathématiques, tout en paraissant moins polyvalent sur d’autres dimensions, notamment quand la discipline d’instruction devient critique. Pour un service client, cette discipline compte énormément. Répondre juste ne suffit pas. Il faut répondre dans le bon format, avec le bon ton, sans exposer d’informations inutiles, et en respectant un parcours précis.
Cette lecture a une conséquence stratégique. Beaucoup d’entreprises ont longtemps choisi leur moteur en suivant le buzz. Or le buzz favorise les annonces spectaculaires, pas la qualité répétable. Une société de e-commerce, par exemple, n’a pas besoin d’un champion de logique abstraite si son enjeu principal est de traiter correctement les demandes de livraison, retours et disponibilité produit. Dans ce cas, la supériorité globale d’un numéro un doit être confrontée à un test métier ciblé. C’est aussi l’esprit des contenus comme ce guide pour choisir une solution chatbot ou notre analyse de Gemini en contexte B2B.
> Le vrai numéro un n’est pas celui qui impressionne sur X. C’est celui qui réduit vos tickets, améliore vos conversions ou écourte vos appels.
Autre signal à ne pas négliger : les écarts entre leaders se resserrent souvent. Cela veut dire qu’une première place ne crée pas automatiquement un fossé opérationnel. Entre un modèle classé premier et un autre classé troisième, l’écart peut être sensible sur des benchmarks experts mais marginal sur des parcours clients simples. C’est là que la discipline budgétaire reprend ses droits. Si le deuxième coûte moins cher, s’intègre mieux et atteint 95 % du résultat utile, la décision n’est plus seulement technique. Elle devient économique.
| Modèle | Forces souvent observées | Points de vigilance | Lecture business |
|---|---|---|---|
| ChatGPT-4o-latest | Polyvalence, instruction, code, prompts complexes | Coût et dépendance fournisseur à surveiller | Très bon choix pour usages larges |
| Gemini 1.5 | Mathématiques, tâches difficiles, rival crédible | Moins homogène sur certains usages | Intéressant selon vos scénarios |
| Grok-2 | Bon niveau global | Régularité plus variable | À tester plutôt qu’acheter sur réputation |
| Claude 3.5 Sonnet | Qualité rédactionnelle et raisonnement ciblé | Polyvalence à vérifier | Très pertinent pour certains flux |
C’est précisément ce que propose AirAgent, solution française pensée pour transformer la qualité d’un moteur IA en résultats mesurables sur des cas d’usage concrets, sans alourdir le projet côté métier.
Une fois le haut du tableau compris, il reste l’étape la plus utile pour un décideur : transformer un score public en décision opérationnelle. Et c’est là que beaucoup d’entreprises se trompent.
Pourquoi un bon classement IA ne suffit pas pour choisir le bon chatbot en entreprise
Le réflexe classique consiste à regarder le premier du classement, puis à en déduire qu’il s’agit du meilleur choix. C’est compréhensible. C’est aussi souvent une erreur coûteuse. Un chatbot d’entreprise ne vit pas dans une arène. Il vit dans un site web, un CRM, une base documentaire, un centre d’appels ou une application métier. Sa valeur dépend autant du moteur que de son cadrage, de ses garde-fous, de son architecture de réponses et de sa capacité à tenir une tâche. C’est pour cela qu’un excellent rang public doit être considéré comme un filtre d’entrée, pas comme un verdict final.
Prenons le cas fictif de Martin, dirigeant d’une PME de services B2B à Lyon. Son équipe reçoit 180 demandes hebdomadaires, dont 60 % portent sur les mêmes sujets : devis, délais, pièces à fournir, suivi de dossier. Martin lit que tel modèle domine l’arena. Il peut foncer tête baissée. Ou il peut poser les bonnes questions : le système comprend-il bien le français métier ? Gère-t-il les reformulations ? Peut-il limiter les hallucinations ? Est-il simple à superviser par une équipe non technique ? Dans la vraie vie, ces questions décident du retour sur investissement.
- Coût réel par interaction et par mois
- Temps de déploiement et facilité d’administration
- Qualité en français sur votre vocabulaire métier
- Connexion aux outils existants
- Contrôle des réponses, escalade vers un humain et reporting
À retenir : le classement identifie des moteurs prometteurs. Il ne remplace jamais un test sur vos propres scénarios, avec vos règles et vos indicateurs.
La confusion vient souvent d’un glissement entre performance générale et efficacité métier. Une IA peut très bien réussir des prompts complexes et échouer à suivre un script commercial simple. Elle peut rédiger des réponses élégantes et mal appliquer votre politique de remboursement. Elle peut aussi être excellente en anglais et plus inégale sur certaines formulations françaises. Pour éviter cela, une entreprise doit construire son propre protocole d’évaluation. Quelques dizaines de cas bien choisis valent mieux qu’une fascination pour un leaderboard global.
Si vous démarrez ce travail, des ressources comme notre méthode pour évaluer la qualité d’un échange IA ou ces 5 critères pour choisir un chatbot vous feront gagner du temps. Vous pouvez aussi comparer les lectures externes de l’arena, comme ce guide complet sur le fonctionnement de Chatbot Arena, afin de mieux distinguer score public et adéquation opérationnelle.
> Une IA classée première qui répond mal à vos 20 demandes les plus fréquentes vaut moins qu’une solution classée troisième mais parfaitement cadrée.
Attention : beaucoup de projets échouent non à cause du modèle, mais à cause d’une base de connaissances mal structurée, d’objectifs vagues ou d’une absence de suivi après lancement.
Le plus rentable consiste donc à associer trois niveaux de lecture. D’abord, un classement public pour éviter les options faibles. Ensuite, un test métier court mais strict. Enfin, une validation économique : coût, charge interne, supervision, impact commercial ou support. Cette méthode est plus sobre, plus rapide et bien plus fiable qu’une décision guidée par la mode du moment.
| Question | Si la réponse est oui | Si la réponse est non |
|---|---|---|
| Le modèle suit-il vos consignes métier ? | Passe au test utilisateur | Écartez-le vite |
| Le français est-il solide sur vos cas ? | Mesurez le gain de productivité | Revoyez la présélection |
| L’intégration est-elle simple ? | Calculez le ROI | Ajoutez le coût projet caché |
| Le reporting est-il exploitable ? | Pilotage possible | Risque d’aveuglement opérationnel |
Notre recommandation : pour une PME, cherchez une solution qui combine rapidité de déploiement, pilotage métier sans jargon et mesure claire des gains. Pour cela, découvrir la solution peut être plus utile qu’ajouter un énième benchmark à votre pile de lecture.
À partir de là, la question n’est plus “qui est premier ?”, mais “comment transformer ce signal en déploiement rentable ?”. C’est le sujet de la dernière partie utile avant la FAQ.
Comment utiliser Chatbot Arena pour sélectionner une IA conversationnelle rentable
La meilleure façon d’utiliser Chatbot Arena n’est pas de copier son classement dans un comité de direction. Il faut s’en servir comme d’un radar. Vous repérez les modèles régulièrement bien placés, vous éliminez les options faibles, puis vous construisez un test métier serré. Cette méthode réduit les erreurs de casting. Elle évite aussi de lancer un projet trop technique, trop long ou trop cher. Pour un décideur, l’enjeu n’est pas d’adopter “la meilleure IA du monde”, mais celle qui traite correctement un volume précis de demandes à un coût soutenable.
Le plus efficace consiste à partir de vos cas d’usage. Un service commercial ne testera pas les mêmes choses qu’un support client ou qu’une équipe RH. Pour un chatbot de prospection, on mesurera la qualification, la clarté des questions et la prise de rendez-vous. Pour un assistant SAV, on regardera la précision, la capacité à résumer une procédure et l’orientation rapide vers un humain si nécessaire. Cette logique par métier est bien plus rentable qu’une fascination pour la seule sophistication du moteur.
- Identifiez vos 20 à 30 questions ou scénarios les plus fréquents.
- Retenez 2 à 3 moteurs bien classés dans l’arena.
- Testez-les en français, sur vos règles et vos contenus.
- Mesurez la qualité, le taux de bonne orientation et le temps gagné.
- Comparez ensuite le coût complet de chaque option.
Conseil : demandez à vos équipes de noter non seulement la justesse, mais aussi la clarté, le ton, la conformité et la capacité à rester dans le cadre.
Cette démarche peut être reliée à d’autres ressources utiles du site, par exemple notre guide sur le chatbot pour site internet, ce dossier sur l’agent conversationnel en entreprise ou notre page sur le traitement du langage naturel. Vous passez ainsi d’une logique de curiosité à une logique de décision. C’est exactement ce qu’un dirigeant attend d’un média expert : moins de bruit, plus de critères utiles.
> La bonne méthode consiste à partir du besoin, utiliser l’arena comme filtre, puis décider avec vos propres indicateurs de terrain.
Il existe aussi un angle souvent sous-estimé : la vitesse de mise en œuvre. Un modèle très bien classé mais complexe à intégrer peut perdre son avantage si votre équipe met trois mois à le cadrer. À l’inverse, une solution un peu moins prestigieuse sur le papier, mais prête à l’emploi et bien pilotée, peut produire des gains dès les premières semaines. Dans une PME, ce délai fait la différence entre un projet qui vit et un projet qui traîne.
Bon à savoir : dans beaucoup d’organisations, les gains les plus rapides viennent des demandes répétitives, pas des cas rares et complexes. Ciblez d’abord le volume.
Pour finir, reliez toujours la sélection du moteur à un indicateur de résultat. Quelques exemples simples : réduction du nombre d’emails entrants, baisse du temps passé sur les demandes récurrentes, augmentation du taux de prise de rendez-vous, amélioration de la satisfaction ou hausse du taux de conversion sur une page stratégique. Sans cela, vous avez un test technique. Avec cela, vous avez un projet pilotable.
| Étape | Objectif | Indicateur conseillé |
|---|---|---|
| Présélection via arena | Écarter les moteurs faibles | Top 3 ou top 5 pertinents |
| Test métier | Mesurer l’adéquation réelle | Taux de bonnes réponses |
| Pilote limité | Valider l’usage sur le terrain | Temps gagné par équipe |
| Décision finale | Arbitrer qualité/coût/délai | ROI à 3 ou 6 mois |
Calculez votre ROI avec AirAgent
À ce stade, vous n’avez plus seulement compris comment les modèles de langage sont classés. Vous savez surtout comment exploiter ce classement pour choisir une solution d’IA conversationnelle qui serve votre activité au lieu d’alimenter une veille stérile.
Chatbot Arena est-elle fiable pour comparer des modèles de langage ?
Oui, comme outil de présélection. Sa force vient des duels anonymes et des votes humains. Sa limite est qu’elle ne remplace pas des tests sur vos propres cas d’usage, vos contraintes métier et votre budget.
Pourquoi ChatGPT-4o a-t-il longtemps dominé le classement ?
Parce qu’il a montré une grande régularité sur plusieurs catégories à la fois : suivi des instructions, codage, mathématiques et prompts complexes. Cette polyvalence a fortement pesé dans les votes comparatifs.
Le meilleur modèle de l’arena est-il forcément le meilleur pour une PME ?
Non. Une PME doit aussi regarder la qualité en français, l’intégration aux outils existants, la simplicité de pilotage, le coût par usage et la capacité à respecter des consignes métier strictes.
Que mesure exactement le système Elo dans Chatbot Arena ?
Il mesure la capacité d’un modèle à gagner des confrontations face à d’autres modèles. Battre un adversaire mieux classé rapporte plus de points. Le score reflète donc une performance comparative perçue par des humains.
Comment choisir entre plusieurs IA bien classées ?
Retenez deux ou trois moteurs, testez-les sur vos scénarios réels, notez la qualité, la clarté, la conformité et le coût, puis arbitrez selon vos indicateurs métier : temps gagné, conversion, satisfaction ou baisse des demandes répétitives.